從失望到提升:大型語言模型輔助編程的實踐之路
核心觀點:大型語言模型(LLM)在程式開發上的效能,取決於「產出」與「後處理」的平衡。作者從 2025 年首次嘗試的失望,到 2026 年透過 agentic IDE 與自訂 agent.md 逐步提升程式品質,說明了目前 LLM 仍需人工驗證與持續調校的現實。
初次嘗試:產出不合格的程式碼
2025 年中,作者在 Rust 語言的 mDNS(多播 DNS)實作 libadbmdns 中使用 LLM,結果產出的程式碼甚至無法編譯。這顯示早期模型在語法正確性與語言特性掌握上仍相當薄弱。
再度探索:功能突破與品質瓶頸
2026 年 1 月,同一模型已能生成複雜的「索引二元堆」類別(indexed‑binary heap)並定位 Windows IOCP(I/O 完成埠)實作中的隱蔽錯誤。然而,程式碼結構混亂、缺乏註解,屬於 spaghetti code(意指錯綜複雜、難以維護的程式),使得原本的加速優勢被大量重構工作抵消。
代理式 IDE 的突破
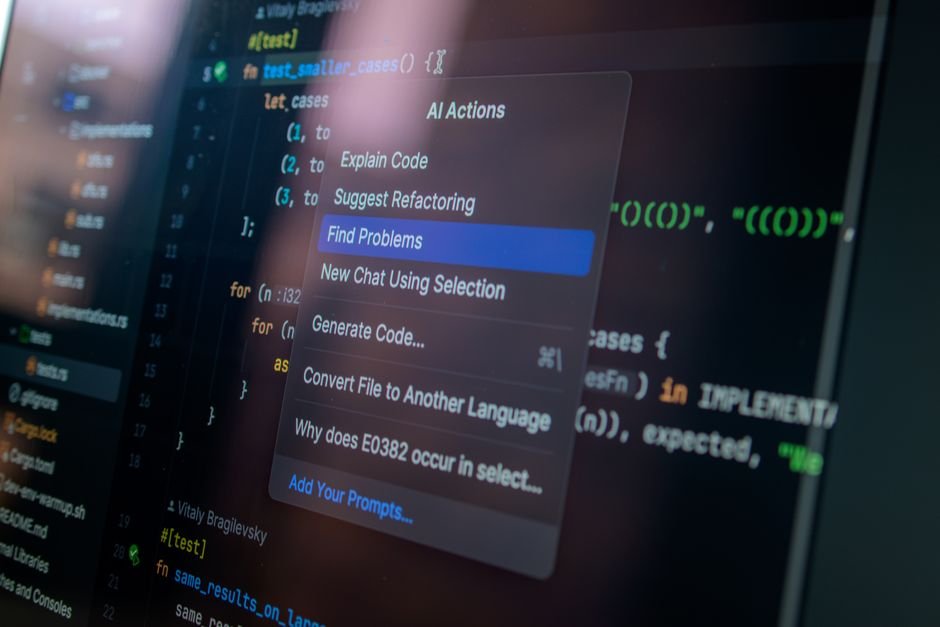
2026 年 3 月,作者改用 Antigravity、VS Code 的 Claude Code 外掛等 agentic IDE(具備 AI 助手的整合開發環境)。這類工具允許在「已暫存」的程式碼上反覆迭代,AI 會像一位耐心的初階程式設計師,提供「不要使用魔術數字」或「加入簡短說明」等即時建議。結果程式碼品質接近手寫水準,但仍需在每次會話中重複相同的指令。
agent.md:將風格偏好寫進提示詞
作者發現,開發環境在啟動時會載入根目錄下的 agent.md,並將其內容注入模型提示。於是將常用的程式風格規範(如命名慣例、註解要求)寫入此檔,形成「超細微調」的持久化設定。只要把 agent.md 放在專案根目錄,或以 symlink 連結 gemini.md、claude.md,即可在任何位置生效。
提示:即使有了
agent.md,LLM 仍會產生幻覺(hallucination),必須由開發者自行驗證。現在的工作重點已從「程式碼風格」轉向「架構設計」與「系統整合」。
注意力稀釋(Context Dilution)問題
根據《Lost in the Middle》論文,隨著提示詞長度增加,模型傾向忽略中段指令,只關注開頭與結尾,形成 attention dilution(注意力稀釋)。作者目前僅找到兩種減緩方法:
-
分段注入:將關鍵指令置於提示詞的開頭或結尾。
-
動態更新:不必每次手動編輯檔案,而是指示 AI 自行修改
agent.md,保持規則最新且位置恰當。
未來展望與讀者啟示
LLM 已從「只能寫出可編譯程式」進化到「能協助除錯與風格統一」,但仍非「免讀碼」的魔法子彈。開發者應將 AI 視為 增效工具,透過自訂提示、持續驗證與架構思考,才能真正提升開發效率。未來若模型在長上下文注意力上取得突破,或能進一步減少人工迭代的成本,LLM 輔助編程的價值將更加顯著。